Go で SIMD を使いたいがアセンブリは書きたくない
- GoでSIMDを使うにはアセンブリを書くしかないと思っている
- Go 1.27で入った
simdパッケージが、どの演算に対応して何ができないのか分からない - 手元のCPUで何レーンになるのか、素直なfor文より速くなるのかを知りたい
対象読者: Goで数値計算・データ処理・暗号まわりのホットスポットを抱えている人。
前提知識: Goのスライスとメソッドの基本、SIMDが「1命令で複数の要素をまとめて処理するCPU機能」だというイメージがあれば読めます。
結論
Go 1.27のsimdパッケージは、レーン幅を型から外した移植性重視のSIMD APIです。ビルド時にGOEXPERIMENT=simdを付けるだけで、同じコードがAVX512でもNEONでもwasmでも動きます。
var a simd.Float32s

for i = 0; i < len(x)-a.Len()+1; i += a.Len() {
	u := simd.LoadFloat32s(x[i : i+a.Len()])
	v := simd.LoadFloat32s(y[i : i+a.Len()])
	a = u.MulAdd(v, a)
}
// 実行結果(手元のマシン)
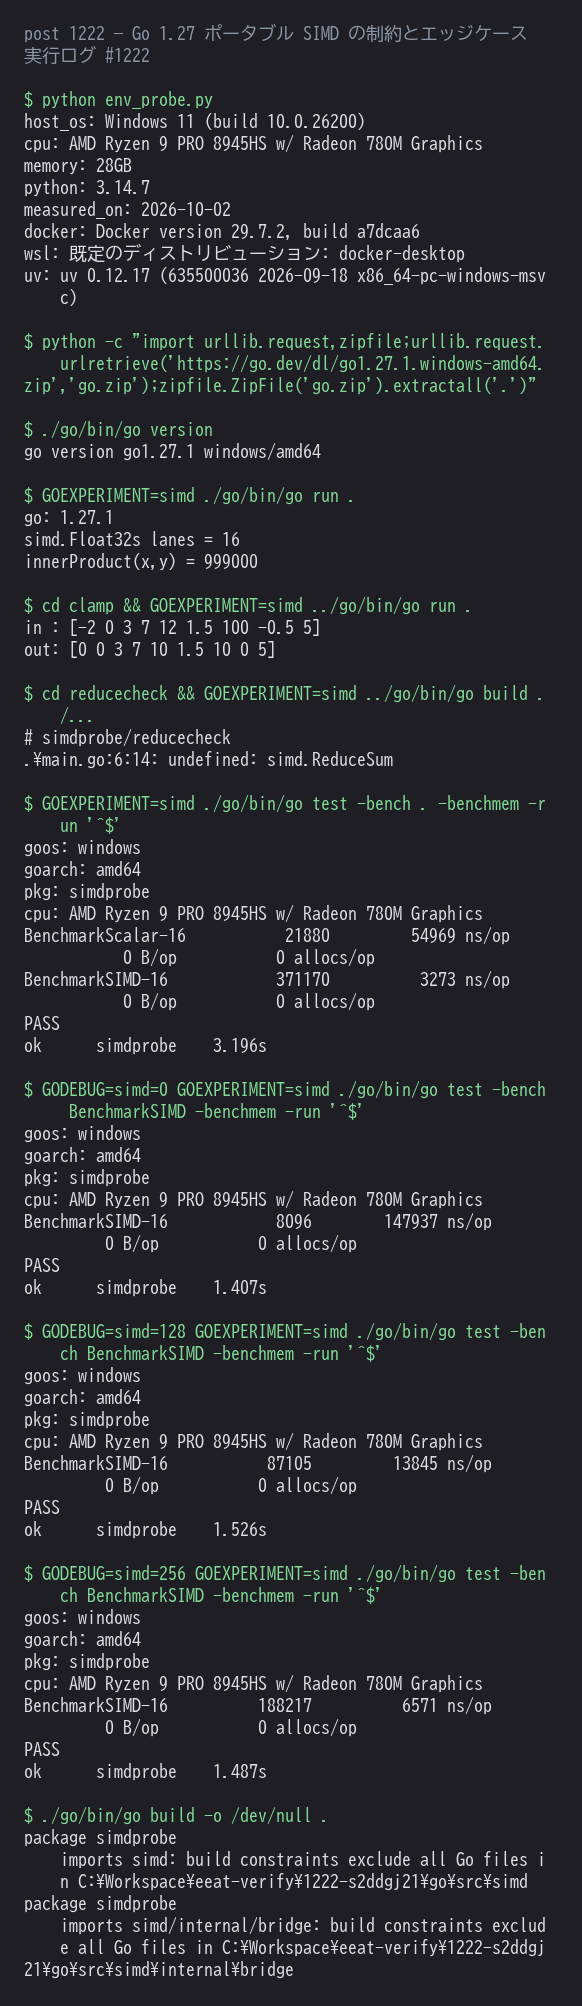
// simd.Float32s lanes = 16レーン幅は型に現れないので、Len()で実行時に取ります。このマシンでは16レーン、つまりAVX512の幅になりました。
simd と archsimd の2階建て
Go 1.27のSIMDは2つのパッケージでできています。下がアーキテクチャ固有のsimd/archsimd、上が移植性重視のsimdです。
| 観点 | simd | simd/archsimd |
|---|---|---|
| 型名 | Float32s(幅を持たない) | Float32x4 / x8 / x16(幅が型に出る) |
| レーン幅 | 実行時にCPUが決める | 型で固定 |
| 使える命令 | 全アーキの共通部分のみ | そのアーキの命令ほぼ全部 |
| 対象 | 1ソースでamd64 / arm64 / wasm | アーキごとに別API |
どちらもGOEXPERIMENT=simdで有効になります。archsimdはGo 1.26からの継続で、1.27ではarm64のNEONとwasmの128ビットSIMDが加わりました。
使える演算と使えない演算
simdパッケージが採用しているのは「全プラットフォームの共通部分」です。全型で使えるのはAdd・Sub・Mul・Min・Max・IfElse・比較・Storeといった基本セットに限られます。
- Float32s / Float64s だけ: Div・Sqrt・MulAdd(積和)・Abs
- 整数だけ: And・Or・Xor・Not・シフト・飽和加算(AddSaturated)
- 1.27では未対応: ベクトル要素の総和、ビット数カウント(OnesCount)、要素の並べ替え
総和が無いのは、要素を横断して足す共通命令が存在しないからです。1.27では自前で足す必要があります。
func sum(x simd.Float32s) float32 {
	s := make([]float32, x.Len())
	x.Store(s)

	var r float32

	for _, e := range s {
		r += e
	}

	return r
}
// 実行結果(Go 1.28で入る予定の ReduceSum を試した場合)
// ./reduce_check.go:6:14: undefined: simd.ReduceSum
Go 1.28ではReduceSum が追加される予定なので、このsumはそのうち1行に置き換えられます。
実践1: 内積をベクトル化する
要素数がレーン幅の倍数でないときは、最後の端数をLoadFloat32sPartで読みます。
func innerProduct(x, y []float32) float32 {
	var a simd.Float32s
	var i int

	for i = 0; i < len(x)-a.Len()+1; i += a.Len() {
		u := simd.LoadFloat32s(x[i : i+a.Len()])
		v := simd.LoadFloat32s(y[i : i+a.Len()])
		a = u.MulAdd(v, a)
	}

	if i < len(x) {
		u, _ := simd.LoadFloat32sPart(x[i:])
		v, _ := simd.LoadFloat32sPart(y[i:])
		a = u.MulAdd(v, a)
	}

	return sum(a)
}
// 実行結果(x[i]=i, y[i]=2, 1000要素)
// innerProduct(x,y) = 999000LoadFloat32sPartは足りない分を0で埋めるので、余りを0として積和しても結果は変わりません。端数処理をこの1行に押し込めるのがありがたいところですね。
実践2: マスクで値をclampする
比較はベクトルではなくマスクを返します。clampはMaxとMinだけで書けます。
func clampVec(x []float32, lo, hi float32) []float32 {
	out := make([]float32, len(x))
	var i int
	l := simd.BroadcastFloat32s(lo)
	h := simd.BroadcastFloat32s(hi)

	for i = 0; i+l.Len() <= len(x); i += l.Len() {
		v := simd.LoadFloat32s(x[i : i+l.Len()])
		v = v.Max(l).Min(h)
		v.Store(out[i : i+l.Len()])
	}

	for ; i < len(x); i++ {
		out[i] = max(lo, min(hi, x[i]))
	}

	return out
}
// 実行結果
// in : [-2 0 3 7 12 1.5 100 -0.5 5]
// out: [0 0 3 7 10 1.5 10 0 5]if文の分岐が必要な場面はIfElse(mask, y)で置き換えられます。比較が返すMask32sをそのまま渡すだけです。
実測: レーン幅と速度
要素数65,536のfloat32で内積を回しました。同じバイナリのまま、GODEBUGでレーン幅を切り替えて測っています。
| レーン幅(GODEBUG) | レーン数 | 1回あたり | スカラー比 |
|---|---|---|---|
| スカラー(比較用) | - | 52,039 ns | 1.0倍 |
| simd=0(エミュレーション) | 4 | 147,439 ns | 0.35倍 |
| simd=128 | 4 | 13,986 ns | 3.7倍 |
| simd=256 | 8 | 6,514 ns | 8.0倍 |
| simd=512(既定) | 16 | 3,285 ns | 15.8倍 |
AVX512が効くマシンではスカラーの約16倍でした。注目したいのはエミュレーションの行で、スカラーより遅くなっています。
エミュレーションはあくまで「動かすため」の経路で、速度のためのフォールバックではありません。SIMD命令が無いCPUでは、ベクトル化したコードが素直なfor文より遅くなる可能性を覚悟しておく必要があります。
つまずきポイント
実際に踏んだものを3つ挙げます。
- GOEXPERIMENT=simdを忘れるとコンパイルできない。
build constraints exclude all Go files in .../src/simdで落ちます。go.modのgoディレクティブでは有効化できず、ビルド時の環境変数が必須です。 - ReduceSumはまだ無い。
undefined: simd.ReduceSumになります。1.27ではStoreでスライスに戻してからスカラーで足してください。 - レーン幅は環境で変わる。 同じソースでも
Len()は4だったり16だったりします。端数処理をLen()基準で書かないと、CPUを変えたときだけおかしくなります。
まとめ
| やりたいこと | 使うもの |
|---|---|
| ベクトル計算を移植性重視で書く | simdパッケージ |
| 特定アーキの命令を使い切る | simd/archsimdパッケージ |
| 有効化する | ビルド時にGOEXPERIMENT=simd |
| レーン幅を知る | Len()(実行時に決まる) |
| 総和を取る | 1.27では自前、1.28でReduceSum予定 |
「アセンブリを書かないとSIMDは使えない」という前提が、Go 1.27でようやく崩れました。まずはホットスポットを1つ選んで、MulAddに置き換えるところから試すのがおすすめです。
検証環境
| OS | Windows 11 (build 10.0.26200) |
|---|---|
| CPU | AMD Ryzen 9 PRO 8945HS w/ Radeon 780M Graphics |
| メモリ | 28GB |
| 言語/ツール | Go 1.27.1(go.dev の公式ポータブル配布 go1.27.1.windows-amd64.zip を一時ディレクトリに展開) |
| 使用コマンド | go run(本体 / clamp) / go build(reducecheck・GOEXPERIMENTなし) / go test -bench(スカラー・simd=0/128/256/512) |
| 測定日 | 2026-10-02 |
上記の環境で実際に実行して確認した結果です。環境が異なる場合は挙動が変わることがあります。
参考
- Platform-independent SIMD in Go — The Go Blog(公式)
- Go 1.27 Release Notes — New experimental simd package(公式)
- simd package — Go パッケージドキュメント(公式)
- simd: architecture and vector-size agnostic SIMD intrinsics(公式プロポーザル)
あわせて読みたい
- 【Go】Go 1.27 の goroutineleak を GC で検出する方法
- 【Go】Go 1.27 ジェネリックメソッド — できること・できないこと
- 【Go 1.26.8】Green Tea GC — 実効性と新機能まとめ
- 【Python】flake8 + black + isort から Ruff 0.17 へ移行したログ — 実際に壊れた4箇所
【広告】このサイトはConoHa WINGで運営しています。安定した高速サーバーで快適にブログを書けています。いつもありがとう!!
コメント