この記事が解決する悩み
- Rust 1.98 に上げたいけれど、何が速くなるのか、何が壊れるのか分からない
- format_into や algebraic_add という名前は見かけたけど、効果が実感できない
- derive(PartialOrd) の挙動が変わったらしく、自分のコードへの影響を判断できない
対象読者は、Rust を業務か個人開発で書いていて、rustup でのツールチェーン更新に慣れているエンジニアです。
トレイト・ジェネリクス・derive マクロの基本は知っている前提で進めます。
結論
1.98 の目玉は「整数を文字列にする標準の速い経路」と「浮動小数点の最適化を許可するメソッド」です。まずは手元のバージョンを確認しましょう。
rustup update stable
rustc --version

# 実行結果
# rustc 1.98.1 (48a229cea 2026-09-01)
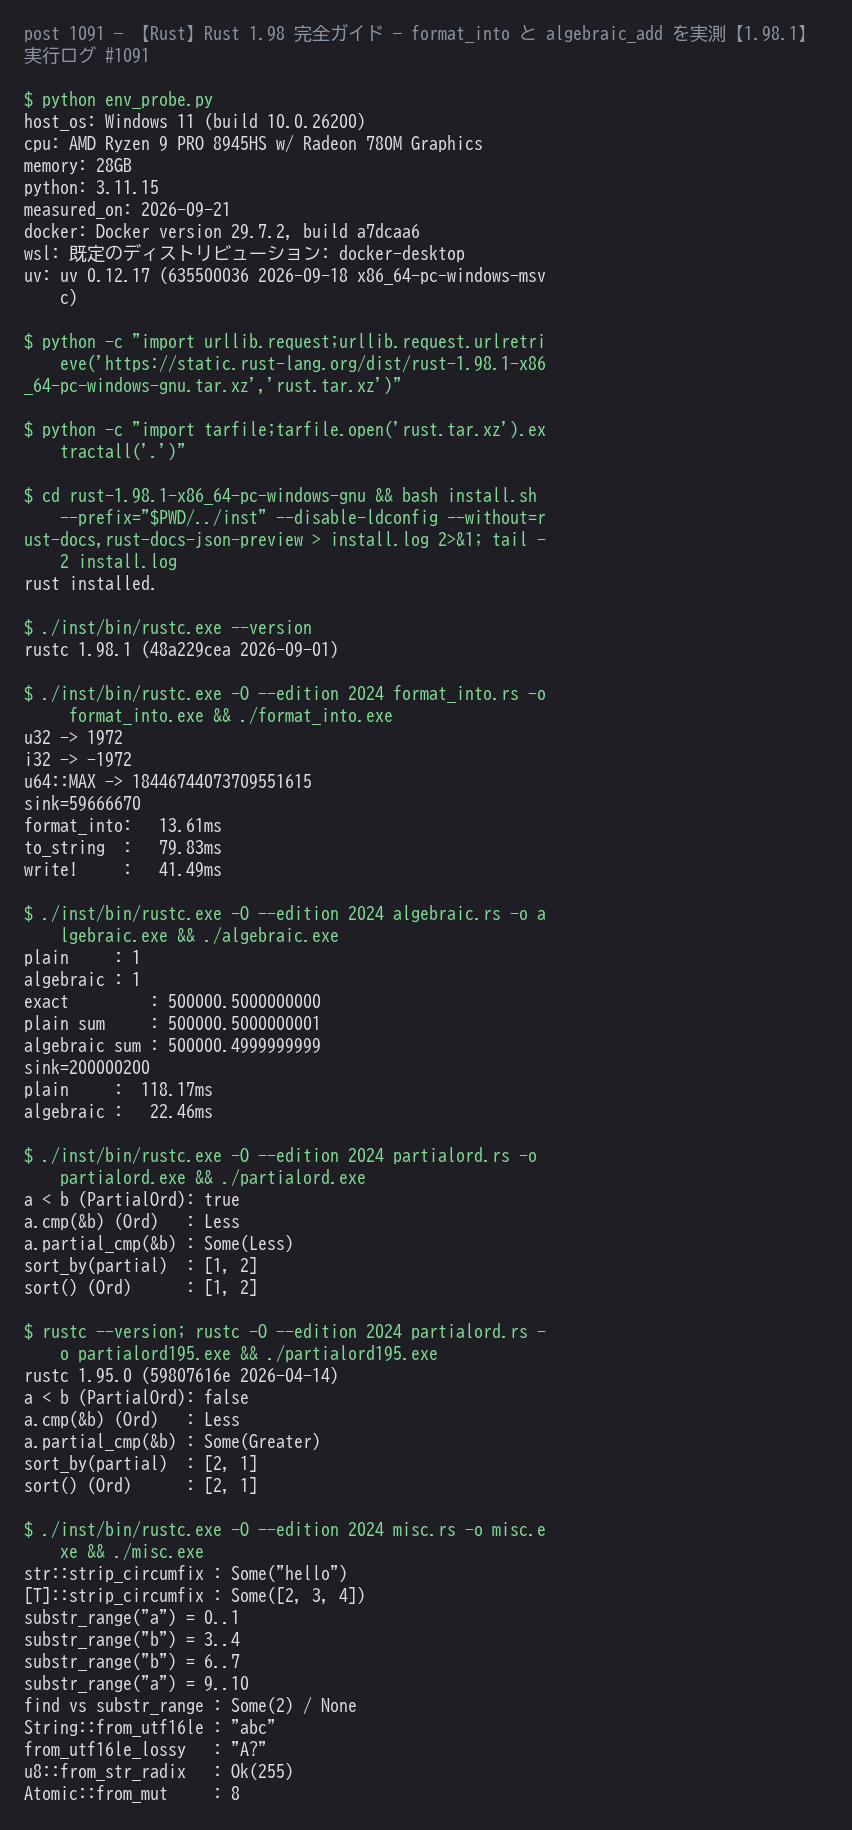
整数の整形は format_into に置き換えるだけで速くなります。
use core::fmt::NumBuffer;

let mut buf = NumBuffer::new();
let n = 1972u32;
println!("{}", n.format_into(&mut buf));

// 実行結果
// 1972
上げるなら 1.98.0 ではなく 1.98.1 を選んでください。1.98.0 には vtable 生成の誤コンパイルが混ざっています。
Rust 1.98 で入った新機能
1.98.0 は 2026年8月20日にリリースされました。目玉は3つです。
format_intoとNumBuffer— 整数を確保なしで文字列化するalgebraic_addなどの代数メソッド — 浮動小数点の再結合をコンパイラに許可するderive(PartialOrd)の高速化 — 唯一の互換性リスク
地味な安定化APIも増えています。
| API | できること |
|---|---|
str::strip_circumfix | 前後の区切りをまとめて落とす |
str::substr_range | 部分文字列が元の文字列のどこを指すかを返す |
String::from_utf16le | UTF-16LE のバイト列から String を作る |
Atomic::from_mut | &mut T から Atomic を作る |
NonZero::from_str_radix | 基数を指定して NonZero をパースする |
このあたりを実際に動かした結果です。
println!("{:?}", "[hello]".strip_circumfix('[', ']'));

let v = [1, 2, 3, 4, 5];
println!("{:?}", v.strip_circumfix(&[1], &[5]));

let data = "a, b, b, a";

for part in data.split(", ") {
    match data.substr_range(part) {
        Some(r) => println!("{:?} = {}..{}", part, r.start, r.end),
        None => println!("{:?} = None", part),
    }
}

let bytes: Vec<u8> = "abc".encode_utf16().flat_map(|u| u.to_le_bytes()).collect();
println!("{:?}", String::from_utf16le(&bytes).unwrap());

// 実行結果
// Some("hello")
// Some([2, 3, 4])
// "a" = 0..1
// "b" = 3..4
// "b" = 6..7
// "a" = 9..10
// "abc"
format_into で整数→文字列を速くする
format_into は整数をバッファに書き込んで &str を返すメソッドです。確保も動的ディスパッチもありません。
300万回まわして to_string と write! と比べてみました。
const N: u64 = 3_000_000;
let mut sink = 0usize;

// 1. format_into
let start = Instant::now();

for i in 0..N {
    let mut buf = NumBuffer::new();
    sink += i.format_into(&mut buf).len();
}

let fmt_into = start.elapsed();

// 2. to_string(毎回 String を確保する)
let start = Instant::now();

for i in 0..N {
    sink += i.to_string().len();
}

let to_string = start.elapsed();

// 3. write!(String を1本使い回す)
let start = Instant::now();
let mut s = String::with_capacity(20);

for i in 0..N {
    s.clear();
    write!(s, "{}", i).unwrap();
    sink += s.len();
}

let write_fmt = start.elapsed();

// それぞれの elapsed を表示する(sink は最適化で消えないように足し込む)

// 実行結果
// sink=59666670
// format_into:   13.61ms
// to_string  :   79.83ms
// write!     :   41.49ms
to_string は毎回 String を確保するので、この差は確保回数の差でもあります。
itoa クレートを入れていたプロジェクトなら、依存を1つ減らせる置き換え候補になりますよ。
algebraic_add で浮動小数点の再結合を許可する
algebraic_add は「実数の結合法則を仮定して最適化してよい」とコンパイラに伝えるメソッドです。f32 と f64 に加減乗除と剰余の5つが入りました。
結果の値も変わります。100万件の総和で確かめました。
fn plain_sum(xs: &[f64]) -> f64 {
    let mut total: f64 = 0.0;

    for x in xs {
        total = total + *x;
    }

    total
}

fn algebraic_sum(xs: &[f64]) -> f64 {
    let mut total: f64 = 0.0;

    for x in xs {
        total = total.algebraic_add(*x);
    }

    total
}

let big: Vec<f64> = (1..=1_000_000).map(|i| i as f64 * 1e-6).collect();
println!("exact         : {:.10}", 500000.5);
println!("plain sum     : {:.10}", plain_sum(&big));
println!("algebraic sum : {:.10}", algebraic_sum(&big));

// 実行結果
// exact         : 500000.5000000000
// plain sum     : 500000.5000000001
// algebraic sum : 500000.4999999999
同じ配列を200回合計した時間です。
// plain_sum と algebraic_sum を同じ配列で200回ずつ合計する
let start = Instant::now();

for _ in 0..200 {
    sink += plain_sum(&big);
}

let plain = start.elapsed();

// 実行結果
// plain     :  118.17ms
// algebraic :   22.46ms
LLVM がループをベクトル化して、部分和を同時に計算できるようになったためです。約5倍になりました。
値が変わる点には注意してください。代数メソッドのほうが正解に近いのは、丸めの順序が変わった結果であって、精度が上がったわけではありません。
derive(PartialOrd) の挙動が変わった
1.98 の互換性ノートで、唯一「crates を壊しうる」と書かれている変更です。Ord も一緒に derive している型では、PartialOrd が Ord::cmp に委譲されるようになりました。
フィールドの型が PartialOrd と Ord で食い違っていると、比較の答えが変わります。
#[derive(Debug, PartialEq, Eq)]
struct Weird(u32);

// PartialOrd は逆順、Ord は正順(わざと食い違わせる)
impl PartialOrd for Weird {
    fn partial_cmp(&self, other: &Self) -> Option<Ordering> {
        Some(other.0.cmp(&self.0))
    }
}

impl Ord for Weird {
    fn cmp(&self, other: &Self) -> Ordering {
        self.0.cmp(&other.0)
    }
}

#[derive(Debug, PartialEq, Eq, PartialOrd, Ord)]
struct Outer {
    w: Weird,
}

let a = Outer { w: Weird(1) };
let b = Outer { w: Weird(2) };

println!("a < b (PartialOrd): {}", a < b);
println!("a.cmp(&b) (Ord)   : {:?}", a.cmp(&b));
println!("a.partial_cmp(&b) : {:?}", a.partial_cmp(&b));
同じソースを 1.95.0 と 1.98.1 でビルドした結果を並べます。
| 式 | 1.95.0 | 1.98.1 |
|---|---|---|
a < b | false | true |
a.partial_cmp(&b) | Some(Greater) | Some(Less) |
a.cmp(&b) | Less | Less |
sort_by(partial_cmp) | [2, 1] | [1, 2] |
どちらの実装も間違いではありません。食い違っていること自体が問題で、1.98 はそれを表面化させます。
Ord と PartialOrd を手書きするときは、partial_cmp を Some(self.cmp(other)) に寄せておくと安全です。
つまずきポイント
core::fmt::NumBufferはstd::fmtに再輸出されていない。edition 2015 の bin クレートでuse core::fmt::NumBuffer;と書くと E0433 になるので、--edition 2024を付けるalgebraic_addはレシーバーの型が決まっていないと E0689「can’t call methodalgebraic_addon ambiguous numeric type」になる。let mut total: f64 = 0.0;のように型を書くstr::substr_rangeは検索しない。ポインタ演算で「元の文字列のどこか」を判定するだけなので、別のリテラルを渡すとNoneになる("abcdef".find("cd")はSome(2)、"abcdef".substr_range("cd")はNone)[T]::strip_circumfixは&[1]のように参照で渡す。&1と書くとSlicePatternが実装されていない型として E0277 になる- 1.98.0 には vtable 生成の誤コンパイルがある。1.98.1 へ上げる(
rustup update stable)
検証環境
| OS | Windows 11 (build 10.0.26200) |
|---|---|
| CPU | AMD Ryzen 9 PRO 8945HS w/ Radeon 780M Graphics |
| メモリ | 28GB |
| 言語/ツール | rustc 1.98.1(公式ポータブル配布 rust-1.98.1-x86_64-pc-windows-gnu.tar.xz を一時ディレクトリに展開) / rustc 1.95.0(比較用・ホスト既存の rustup 管理) |
| 使用コマンド | rustc -O –edition 2024(各サンプルを実行)/ rustc –version |
| 測定日 | 2026-09-21 |
上記の環境で実際に実行して確認した結果です。環境が異なる場合は挙動が変わることがあります。
まとめ
用途別にまとめます。
| やりたいこと | 書くもの | 備考 |
|---|---|---|
| 整数を確保なしで文字列化する | n.format_into(&mut buf) | NumBuffer::new() を用意する |
| 浮動小数点の再結合を許可する | a.algebraic_add(b) | 値が変わりうる |
| Ord と PartialOrd を手書きする | Some(self.cmp(other)) | 1.98 の高速化と整合する |
| 1.98 系へ上げる | rustup update stable | 1.98.1 以上を選ぶ |
1.98 は「性能の取り分」が多いリリースです。既存コードを書き換えなくても、format_into に置き換えるだけで効果が出ますよ。
まずは rustup update stable と format_into の置き換えから試してみてください。
参考
本文の記述は以下の一次情報を確認して書いています。
- Announcing Rust 1.98.0(Rust Blog)
- Announcing Rust 1.98.1(Rust Blog)
- Rust Release Notes(1.98.0 の言語・ライブラリ・互換性ノート)
- core::fmt::NumBuffer(標準ライブラリ)
- f64::algebraic_add(標準ライブラリ)
- API change proposal: buffered integer formatting(libs-team #532)
- RFC 3336: MaybeDangling(ManuallyDrop と Box の相互作用)
あわせて読みたい
- 【C#】C# 14 逆引き — field・拡張メンバー・null条件代入【.NET 10】
- 【Java】JDK 27 逆引き — LazyConstant・プリミティブ型パターン
- 【Kotlin】Kotlin 2.4.20 完全ガイド — SwiftエクスポートとWasm対応
- 【Rust】非同期クロージャ(async || {})の書き方・移行ガイド
【広告】お名前.comならドメイン取得が格安。
【広告】このサイトはConoHa WINGで運営しています。安定した高速サーバーで快適にブログを書けています。いつもありがとう!!
コメント